DeepSeek-671B 硬件配置
一、模型参数与量化类型
1. 模型参数数量
模型参数数量是指神经网络的"大脑容量",通常以十亿(B)为单位:
• 参数越多,模型的能力越强
• 1B = 10亿参数
• 7B/14B 适合单机部署
• 32B+ 通常需要多卡部署
| DeepSeek-1.5B | DeepSeek-7B |
|---|---|
| DeepSeek-8B | DeepSeek-14B |
| DeepSeek-32B | DeepSeek-70B |
| DeepSeek-671B |
参数量越大,需要的显存就越多,请根据实际硬件配置选择合适的模型规模。
2. 量化类型
量化是压缩模型参数的一种方法,不同量化类型对应不同的参数存储大小:
| 精度 | 说明 |
|---|---|
| FP32(32-bit) | 完整精度;无精度损失;显存占用最大 |
| FP16(16-bit) | 半精度浮点;显存减少50%;几乎无精度损失 |
| FP8(8-bit) | 8位浮点量化;显存减少75%;轻微精度损失(<1%);支持 H100 硬件加速 |
| INT8(8-bit) | 8位整数量化;显存减少75%;轻微精度损失(1-2%) |
| INT4(4-bit) | 4位整数量化;显存减少87.5%;中等精度损失(2-3%) |
注意:
• 量化程度越高,显存占用越少,但可能带来一定的精度损失
• 建议根据实际需求在性能和精度间权衡
二、运行参数配置
1. 序列长度说明
序列长度是模型一次能处理的最大token数:
| 序列长度 | 描述 |
|---|---|
| 2K (2048) | 标准长度,适合一般对话 |
| 4K (4096) | 中等长度,可处理较长文档 |
| 8K (8192) | 较长上下文,适合长文分析 |
| 32K+ | 超长上下文,可处理书籍级内容 |
注意事项:
• 序列长度越长,显存占用越大
• 显存占用与序列长度成正比
• 建议根据实际需求选择合适长度
2. 批次大小说明
批次大小决定了模型一次处理的请求数量:
| 批次大小 | 描述 |
|---|---|
| 1-16 | 低延迟场景- 适合实时聊天- 最小响应时间- 较低显存占用 |
| 32-64 | 平衡延迟和吞吐量- 适合混合工作负载- 中等显存占用- 高效资源利用 |
| 64+ | 高吞吐量场景- 批处理- 最大GPU利用率- 更高显存需求 |
注意:
• 批次越大,显存占用越高
• 根据实际并发需求选择
• 动态批处理可自动调整批次大小
• 设置批次大小时考虑内存约束
• Tensor并行影响最佳批次大小
三、硬件资源配置
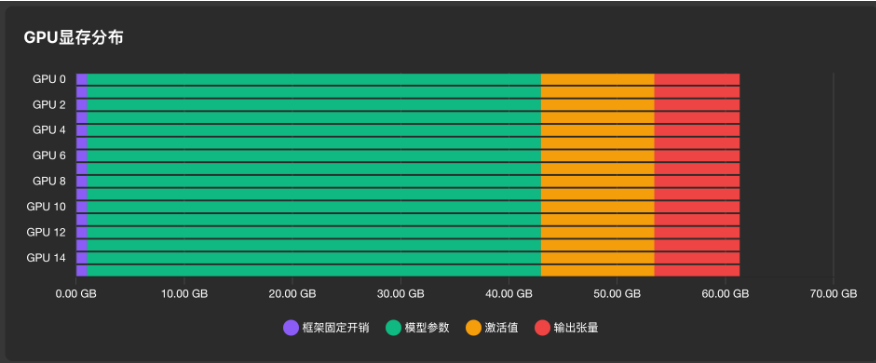
在使用INT8量化,序列长度 32K ,支持32批次大小的场景下,部署DeepSeek-671B的推荐配置:
| 组件 | 推荐配置 |
|---|---|
| CPU | 鲲鹏920双路128核 |
| GPU | 华为 Ascend 910B (64GB) X 16 |
| 内存 | 2048GB DDR5-4800 ECC 8通道 |
| 存储 | 16TB NVMe RAID |