
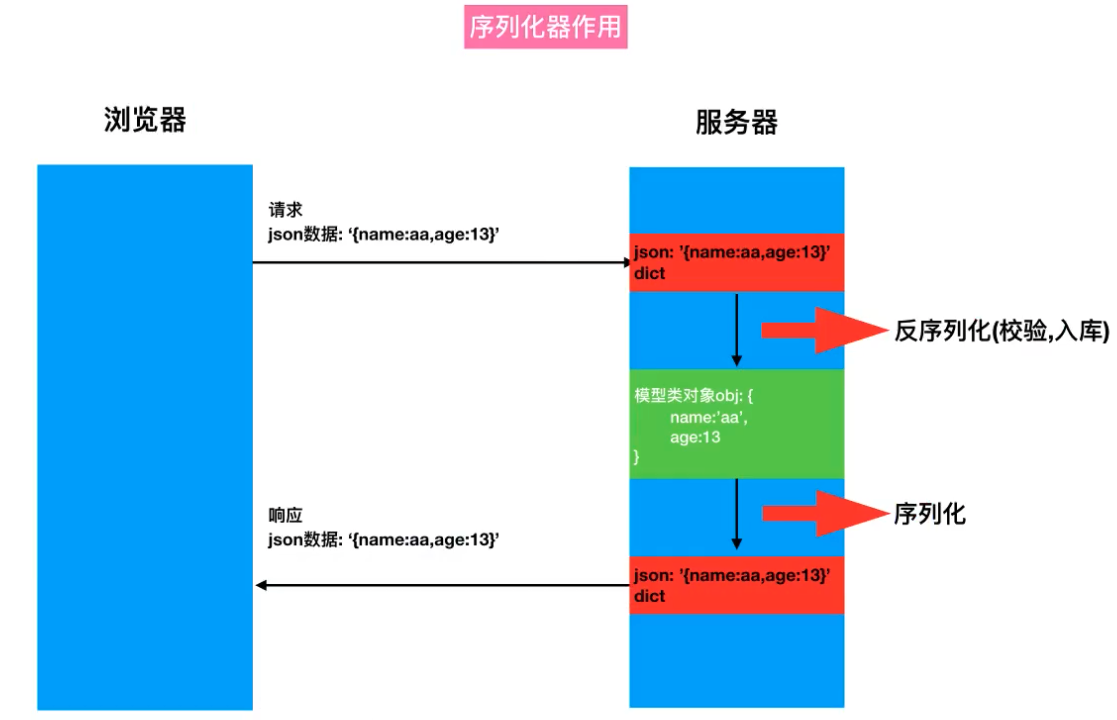
一、序列化器作用
-
反序列化: 把json(dict), 转成模型类对象 (校验,入库)
-
序列化: 将模型类对象, 转成json(dict)数据
二、创建序列化
1. 创建model对象
创建一个图书信息对象和作者对象,在图书信息中通过外键多对一关联作者信息
from django.db import models


class UserInfo(models.Model):
    name = models.CharField(max_length=20, verbose_name='姓名')
    GENDER_CHOICES = (
        (0, 'men'),
        (1, 'women')
    )
    gender = models.SmallIntegerField(choices=GENDER_CHOICES, default=0, verbose_name='性别')
    is_delete = models.BooleanField(default=False, verbose_name='逻辑删除')

    class Meta:
        verbose_name = '作者信息'
        verbose_name_plural = verbose_name

    def __str__(self):
        return self.name


class BookInfo(models.Model):
    name = models.CharField(max_length=20, verbose_name='书名')
    releas_date = models.DateField(verbose_name='发布日期')
    read = models.IntegerField(verbose_name='阅读量', default=0)
    comment = models.IntegerField(verbose_name='评论量', default=0)
    is_delete = models.BooleanField(default=False, verbose_name='逻辑删除')
    author = models.ForeignKey(UserInfo, on_delete=models.CASCADE, verbose_name='作者')

    class Meta:
        verbose_name = '图书信息'
        verbose_name_plural = verbose_name

    def __str__(self):
        return self.name
2. 创建序列化类(app目录下创建serializers.py文件)
定义类,继承自serializer,参照model对象编写,名字,类型,字段选项保持一致,并添加只读的id属性
from rest_framework import serializers

# 定义作者信息序列化器
class UserInfoSerializer(serializers.Serializer):
    GENDER_CHOICES = (
        (0, 'men'),
        (1, 'women')
    )
    id = serializers.IntegerField(label='ID', read_only=True)
    name = serializers.CharField(label='名字', max_length=20)
    gender = serializers.ChoiceField(choices=GENDER_CHOICES, label='性别', required=False)
    is_delete = serializers.BooleanField(default=False, label='逻辑删除')


# 定义图书信息序列化器
class BookInfoSerializer(serializers.Serializer):
    id = serializers.IntegerField(label='id', read_only=True)
    name = serializers.CharField(max_length=20, label='书名')
    releas_date = serializers.DateField(label='发布日期')
    read = serializers.IntegerField(default=0, label='阅读量')
    is_delete = serializers.BooleanField(default=False, label='逻辑删除')
    # 外键关联暂不处理
3. 序列化类参数
- 选项参数
| 参数名称 | 作用 |
|---|---|
| max_length | 最大长度 |
| min_lenght | 最小长度 |
| allow_blank | 是否允许为空 |
| trim_whitespace | 是否截断空白字符 |
| max_value | 最小值 |
| min_value | 最大值 |
- 通用参数
| 参数名称 | 作用 |
|---|---|
| read_only | 表明该字段仅用于序列化输出,默认False |
| write_only | 表明该字段仅用于反序列化输入,默认False |
| allow_blank | 是否允许为空 |
| trim_whitespace | 是否截断空白字符 |
| max_value | 最小值 |
| min_value | 最大值 |
三、使用序列化
1. 序列化单个对象
(venv) localhost:tutorial cuiliang$ python manage.py shell
Python 3.9.0 (default, Nov 20 2020, 18:44:50)
[Clang 12.0.0 (clang-1200.0.32.27)] on darwin
Type "help", "copyright", "credits" or "license" for more information.
(InteractiveConsole)
>>> from quickstart.models import BookInfo
>>> from quickstart.serializers import BookInfoSerializer
>>> # 获取对象
>>> book = BookInfo.objects.get(id=1)
>>> # 创建序列化器
>>> serializer = BookInfoSerializer(instance=book)
>>> # 将对象转换为json
>>> print(serializer.data)
{'id': 1, 'name': '三字经', 'releas_date': '2021-03-01', 'read': 0, 'is_delete': False}

#instance表示要序列化的对象
2. 序列化多个对象(对象列表)
>>> from quickstart.models import BookInfo
>>> from quickstart.serializers import BookInfoSerializer
>>> # 获取对象
>>> books = BookInfo.objects.all()
>>> # 创建序列化器
>>> serializer = BookInfoSerializer(instance=books, many=True)
>>> # 将对象转换为json
>>> print(serializer.data)
[OrderedDict([('id', 1), ('name', '三字经'), ('releas_date', '2021-03-01'), ('read', 0), ('is_delete', False)]), OrderedDict([('id', 2), ('name', '百家姓'), ('releas_dat021-03-01'), ('read', 0), ('is_delete', False)]), OrderedDict([('id', 3), ('name', '撸代码大全'), ('releas_date', '2021-03-13'), ('read', 123), ('is_delete', False)]), OdDict([('id', 4), ('name', '打豆豆'), ('releas_date', '2021-03-15'), ('read', 0), ('is_delete', False)]), OrderedDict([('id', 5), ('name', '吃饭'), ('releas_date', '20212'), ('read', 0), ('is_delete', False)])]

# many=True表示要序列化多个对象
3. 关联对象序列化(对象外键序列化)
在上面的例子中,创建图书信息序列化器时,未对关联外键进行处理,现在修改serializers.py文件图书信息序列化器内容,新增外键属性。在定义外键属性时,根据时间需求,可以序列化后返回不同类型的结果
- 返回外键关联对象的id
# 1.BookInfoSerializer新增序列化对象字段,属性为只读
author = serializers.PrimaryKeyRelatedField(read_only=True)
#或者使用queryset,查询结果一样
author = serializers.PrimaryKeyRelatedField(queryset=BookInfo.objects.all())

# 2.python manage.py shell测试
>>> from quickstart.models import BookInfo
>>> from quickstart.serializers import BookInfoSerializer
>>> # 获取对象
>>> book = BookInfo.objects.get(id=1)
>>> # 创建序列化器
>>> serializer = BookInfoSerializer(instance=book)
>>> # 将对象转换为json
>>> print(serializer.data)
{'id': 1, 'name': '三字经', 'releas_date': '2021-03-12', 'read': 0, 'is_delete': False, 'author': 2}
- 返回外键关联对象的str方法返回值
# 1.BookInfoSerializer新增序列化对象字段
author = serializers.StringRelatedField(read_only=True)

# 2.python manage.py shell测试
>>> from quickstart.models import BookInfo
>>> from quickstart.serializers import BookInfoSerializer
>>> # 获取对象
>>> book = BookInfo.objects.get(id=1)
>>> # 创建序列化器
>>> serializer = BookInfoSerializer(instance=book)
>>> # 将对象转换为json
>>> print(serializer.data)
{'id': 1, 'name': '三字经', 'releas_date': '2021-03-12', 'read': 0, 'is_delete': False, 'author': '张三'}
- 返回userinfo模型所有字段数据
# 1.BookInfoSerializer新增序列化对象字段
author = UserInfoSerializer()

# 2.python manage.py shell测试
>>> from quickstart.models import BookInfo
>>> from quickstart.serializers import BookInfoSerializer
>>> # 获取对象
>>> book = BookInfo.objects.get(id=1)
>>> # 创建序列化器
>>> serializer = BookInfoSerializer(instance=book)
>>> # 将对象转换为json
>>> print(serializer.data)
{'id': 1, 'name': '三字经', 'releas_date': '2021-03-01', 'read': 0, 'is_delete': False, 'author': OrderedDict([('id', 5), ('name', '安德森'), ('gender', 1), ('is_delete': False)])}
-
反向查询序列化(通过用户外键反向查询书籍)
-
Django ORM 一对多反向查询
>>> from quickstart.models import BookInfo, UserInfo
>>> user = UserInfo.objects.get(id=1)
>>> user
<UserInfo: 张三>
>>> user.bookinfo_set.all()
<QuerySet [<BookInfo: 三字经>, <BookInfo: 撸代码大全>]>
- 反向查询关联对象的id
# 1.UserInfoSerializer新增序列化对象字段,属性为只读,关联对象可能为多个,因此必须要加many
bookinfo_set = serializers.PrimaryKeyRelatedField(read_only=True, many=True)

# 2.python manage.py shell测试
>>> from quickstart.models import UserInfo
>>> from quickstart.serializers import UserInfoSerializer
>>> # 获取对象
>>> user = UserInfo.objects.get(id=1)
>>> # 创建序列化器
>>> serializer = UserInfoSerializer(instance=user)
>>> # 将对象转换为json
>>> print(serializer.data)
{'id': 1, 'name': '张三', 'gender': 0, 'is_delete': False, 'bookinfo_set': [1, 3]}
- 反向查询关联对象的__str__返回值
# 1.UserInfoSerializer新增序列化对象字段,属性为只读,关联对象可能为多个,因此必须要加many
bookinfo_set = serializers.StringRelatedField(read_only=True, many=True)

# 2.python manage.py shell测试
>>> from quickstart.models import UserInfo
>>> from quickstart.serializers import UserInfoSerializer
>>> # 获取对象
>>> user = UserInfo.objects.get(id=1)
>>> # 创建序列化器
>>> serializer = UserInfoSerializer(instance=user)
>>> # 将对象转换为json
>>> print(serializer.data)
{'id': 1, 'name': '张三', 'gender': 0, 'is_delete': False, 'bookinfo_set': ['三字经', '撸代码大全']}
四、使用反序列化
1. 数据校验
- 字段类型校验
对传入的数据进行字段类型校验,是否满足序列器定义的字段类型(整形,字符形,日期形等)
传入合法数据校验
>>> from quickstart.serializers import BookInfoSerializer
>>> #1. 模拟前端json数据
>>> new_book = {
...     "name": "孙子兵法",
...     "releas_date": "2020-02-02",
...     "read": "10",
...     "comment": "5",
...     "author": 1
... }
>>> #2. 创建序列化器
>>> serializer = BookInfoSerializer(data=new_book)
>>> #3. 数据校验(如果校验不通过,提示详细信息)
>>> serializer.is_valid(raise_exception=True)
True
>>> #4. 输出校验结果(校验通过——serializer对象,校验不通过——原json数据)
>>> print(serializer.data)
{'name': '孙子兵法', 'releas_date': '2020-02-02', 'read': 10, 'is_delete': False}
传入非法数据校验(read字段传入字符串)
>>> from quickstart.serializers import BookInfoSerializer
>>> #1. 模拟前端json数据
>>> new_book = {
...     "name": "孙子兵法",
...     "releas_date": "2020-02-02",
...     "read": "abc",
...     "comment": 5,
...     "author": 1
... }
>>> #2. 创建序列化器
>>> serializer = BookInfoSerializer(data=new_book)
>>> #3. 数据校验(如果校验不通过,提示详细信息)
>>> serializer.is_valid(raise_exception=True)
Traceback (most recent call last):
  File "<console>", line 1, in <module>
  File "/Users/cuiliang/PycharmProjects/tutorial/venv/lib/python3.9/site-packages/rest_framework/serializers.py", line 228, in is_valid
    raise ValidationError(self.errors)
rest_framework.exceptions.ValidationError: {'read': [ErrorDetail(string='请填写合法的整数值。', code='invalid')]}
>>> #4. 输出校验结果(校验通过——serializer对象,校验不通过——原json数据)
>>> print(serializer.data)
{'name': '孙子兵法', 'releas_date': '2020-02-02', 'read': 'abc'}
- 字段选项校验
对传入的数据进行字段选项校验,是否满足序列器定义的字段选项(最小长度,最大长度,是否可以为空等)
传入非法数据校验(name长度超过20)
>>> from quickstart.serializers import BookInfoSerializer
>>> # 1.模拟前端json数据
>>> new_book = {
...     "name": "孙子兵法,子孙兵法,孙子子孙兵法,管他什么兵法,都是好兵法",
...     "releas_date": "2020-02-02",
...     "read": 10,
...     "comment": 5,
...     "author": 1
... }
>>> # 2.创建序列化器
>>> serializer = BookInfoSerializer(data=new_book)
>>> # 3.数据校验(如果校验不通过,提示详细信息)
>>> serializer.is_valid(raise_exception=True)
Traceback (most recent call last):
  File "<console>", line 1, in <module>
  File "/Users/cuiliang/PycharmProjects/tutorial/venv/lib/python3.9/site-packages/rest_framework/serializers.py", line 228, in is_valid
    raise ValidationError(self.errors)
rest_framework.exceptions.ValidationError: {'name': [ErrorDetail(string='请确保这个字段不能超过 20 个字符。', code='max_length')]}
>>> # 4.输出校验结果(校验通过——serializer对象,校验不通过——原json数据)
>>> print(serializer.data)
{'name': '孙子兵法,子孙兵法,孙子子孙兵法,管他什么兵法,都是好兵法', 'releas_date': '2020-02-02', 'read': 10}
- 单字段校验
序列化器中定义单字段校验方法
# 修改BookInfoSerializer序列器,新增单字段校验方法(name字段不得包含字符)
class BookInfoSerializer(serializers.Serializer):
    id = serializers.IntegerField(label='id', read_only=True)
    name = serializers.CharField(max_length=20, label='书名')
    releas_date = serializers.DateField(label='发布日期')
    read = serializers.IntegerField(default=0, label='阅读量')
    comment = serializers.IntegerField(default=0, label='评论量')
    is_delete = serializers.BooleanField(default=False, label='逻辑删除')
    # 外键关联
    # 外键关联
    author = serializers.PrimaryKeyRelatedField(read_only=True)

    # 单字段校验方法(name字段不得包含字符)
    def validate_name(self, value):
        if value.isalnum():
            # 条件为真,校验通过,直接返回值
            return value
        else:
            # 条件为假,校验不通过,设置异常信息
            raise serializers.ValidationError('书籍名称中不得包含字符')
传入合法数据校验
>>> from quickstart.serializers import BookInfoSerializer
>>> # 1.模拟前端json数据
>>> new_book = {
...     "name": "孙子兵法",
...     "releas_date": "2020-02-02",
...     "read": 10,
...     "comment": 5,
...     "author": 1
... }
>>> # 2.创建序列化器
>>> serializer = BookInfoSerializer(data=new_book)
>>> # 3.数据校验(如果校验不通过,提示详细信息)
>>> serializer.is_valid(raise_exception=True)
孙子兵法
True
>>> # 4.输出校验结果(校验通过——serializer对象,校验不通过——原json数据)
>>> print(serializer.data)
{'name': '孙子兵法', 'releas_date': '2020-02-02', 'read': 10, 'is_delete': False}
传入非法数据校验(name中包含字符)
>>> from quickstart.serializers import BookInfoSerializer
>>>
>>> # 1.模拟前端json数据
>>> new_book = {
...     "name": "孙子兵法-1",
...     "releas_date": "2020-02-02",
...     "read": 10,
...     "comment": 5,
...     "author": 1
... }
>>> # 2.创建序列化器
>>> serializer = BookInfoSerializer(data=new_book)
>>> # 3.数据校验(如果校验不通过,提示详细信息)
>>> serializer.is_valid(raise_exception=True)
孙子兵法-1
Traceback (most recent call last):
  File "<console>", line 1, in <module>
  File "/Users/cuiliang/PycharmProjects/tutorial/venv/lib/python3.9/site-packages/rest_framework/serializers.py", line 228, in is_valid
    raise ValidationError(self.errors)
rest_framework.exceptions.ValidationError: {'name': [ErrorDetail(string='书籍名称中不得包含字符', code='invalid')]}
>>> # 4.输出校验结果(校验通过——serializer对象,校验不通过——原json数据)
>>> print(serializer.data)
{'name': '孙子兵法-1', 'releas_date': '2020-02-02', 'read': 10}
- 多字段校验
序列化器中定义单字段校验方法
class BookInfoSerializer(serializers.Serializer):
    id = serializers.IntegerField(label='id', read_only=True)
    name = serializers.CharField(max_length=20, label='书名')
    releas_date = serializers.DateField(label='发布日期')
    read = serializers.IntegerField(default=0, label='阅读量')
    comment = serializers.IntegerField(default=0, label='评论量')
    is_delete = serializers.BooleanField(default=False, label='逻辑删除')
    # 外键关联
    author = serializers.PrimaryKeyRelatedField(read_only=True)

    # 多字段校验方法(评论数不得大于阅读量)
    def validate(self, attrs):
        read = attrs["read"]
        comment = attrs["comment"]
        if read > comment:
            # 条件为真,校验通过,直接返回值
            return attrs
        else:
            # 条件为假,校验不通过,设置异常信息
            raise serializers.ValidationError('评论数不得大于阅读量')
传入合法数据
>>> from quickstart.serializers import BookInfoSerializer
>>> # 1.模拟前端json数据
>>> new_book = {
...     "name": "孙子兵法-1",
...     "releas_date": "2020-02-02",
...     "read": 10,
...     "comment": 5,
...     "author": 1
... }
>>> # 2.创建序列化器
>>> serializer = BookInfoSerializer(data=new_book)
>>> # 3.数据校验(如果校验不通过,提示详细信息)
>>> serializer.is_valid(raise_exception=True)
True
>>> # 4.输出校验结果(校验通过——serializer对象,校验不通过——原json数据)
>>> print(serializer.data)
{'name': '孙子兵法-1', 'releas_date': '2020-02-02', 'read': 10, 'comment': 5, 'is_delete': False}
传入非法数据(阅读数大于评论量)
>>> from quickstart.serializers import BookInfoSerializer
>>> # 1.模拟前端json数据
>>> new_book = {
...     "name": "孙子兵法-1",
...     "releas_date": "2020-02-02",
...     "read": 10,
...     "comment": 15,
...     "author": 1
... }
>>> # 2.创建序列化器
>>> serializer = BookInfoSerializer(data=new_book)
>>> # 3.数据校验(如果校验不通过,提示详细信息)
>>> serializer.is_valid(raise_exception=True)
Traceback (most recent call last):
  File "<console>", line 1, in <module>
  File "/Users/cuiliang/PycharmProjects/tutorial/venv/lib/python3.9/site-packages/rest_framework/serializers.py", line 228, in is_valid
    raise ValidationError(self.errors)
rest_framework.exceptions.ValidationError: {'non_field_errors': [ErrorDetail(string='评论数不得大于阅读量', code='invalid')]}
>>> # 4.输出校验结果(校验通过——serializer对象,校验不通过——原json数据)
>>> print(serializer.data)
{'name': '孙子兵法-1', 'releas_date': '2020-02-02', 'read': 10, 'comment': 15}
2.数据入库
- 数据创建
序列化器中定义create方法
class BookInfoSerializer(serializers.Serializer):
    id = serializers.IntegerField(label='id', read_only=True)
    name = serializers.CharField(max_length=20, label='书名')
    releas_date = serializers.DateField(label='发布日期')
    read = serializers.IntegerField(default=0, label='阅读量')
    comment = serializers.IntegerField(default=0, label='评论量')
    is_delete = serializers.BooleanField(default=False, label='逻辑删除')
    # 外键关联
    author_id = serializers.IntegerField()

    # 实现数据创建的create方法
    def create(self, validated_data):
        # 创建book对象,创建将校验通过后的数据
        return BookInfo.objects.create(**validated_data)
传入数据测试
>>> from quickstart.serializers import BookInfoSerializer
>>>
>>> # 1.模拟前端json数据
>>> new_book = {
...     "name": "孙子兵法-1",
...     "releas_date": "2020-02-02",
...     "read": 10,
...     "comment": 5,
...     "author_id": 1
... }
>>> # 2.创建序列化器
>>> serializer = BookInfoSerializer(data=new_book)
>>> # 3.数据校验(如果校验不通过,提示详细信息)
>>> serializer.is_valid(raise_exception=True)
True
>>> # 4.数据入库
>>> serializer.save()
<BookInfo: 孙子兵法-1>
- 数据更新
序列化器中定义update方法
class BookInfoSerializer(serializers.Serializer):
    id = serializers.IntegerField(label='id', read_only=True)
    name = serializers.CharField(max_length=20, label='书名')
    releas_date = serializers.DateField(label='发布日期')
    read = serializers.IntegerField(default=0, label='阅读量')
    comment = serializers.IntegerField(default=0, label='评论量')
    is_delete = serializers.BooleanField(default=False, label='逻辑删除')
    # 外键关联
    author_id = serializers.IntegerField()

    # 实现数据创建的create方法
    def create(self, validated_data):
        # 创建book对象,创建将校验通过后的数据
        return BookInfo.objects.create(**validated_data)

    # 实现数据更新的update方法
    def update(self, instance, validated_data):
        # 更新数据
        instance.name = validated_data['name']
        instance.releas_date = validated_data['releas_date']
        instance.read = validated_data['read']
        instance.comment = validated_data['comment']
        instance.is_delete = validated_data['is_delete']
        instance.author_id = validated_data['author_id']
        # 入库
        instance.save()
        # 返回
        return instance
传入数据测试
>>> from quickstart.models import BookInfo
>>> from quickstart.serializers import BookInfoSerializer
>>> # 1.模拟前端json数据
>>> new_book = {
...     "name": "孙子兵法-2",
...     "releas_date": "2020-02-02",
...     "read": 10,
...     "comment": 5,
...     "author_id": 1
... }
>>> # 2.获取更新对象
>>> book = BookInfo.objects.get(id=1)
>>> # 2.创建序列化器(将修改的对象序列化,并将传入数据反序列化)
>>> serializer = BookInfoSerializer(instance=book, data=new_book)
>>> # 3.数据校验(如果校验不通过,提示详细信息)
>>> serializer.is_valid(raise_exception=True)
True
>>> # 4.数据入库
>>> serializer.save()
<BookInfo: 孙子兵法-2>
五、模型序列化器
如果我们想要使用序列化器对应的是 Django 的模型类,DRF 为我们提供了 ModelSerializer 模型类序列化器来帮助我们快速创建一个 Serailizer 类
ModelSerializer 与常规的 Serializer 相同,但提供了:
- 基于 模型类自动生成一系列字段
- 基于模型类自动为 Serializer 生成 validators
- 包含默认的 create() 和 update() 的实现
1. 定义模型序列化器
- 选项参数
| 选项 | 参数 | 说明 |
|---|---|---|
| model | 模型类名 | 指明参照哪个模型类 |
| fields | all 表名包含所有字段,也可以写明具体哪些字段 | 指明为模型类的哪些字段生成 |
| exclude | 排除的字段名称列表 | 排除掉哪些字段 |
| depth | 嵌套的层级数量 | ModelSerializer 使用主键作为关联字段,会自动通过主键找下一级的关联字段,可以指定向下找的层级 |
| read_only_fields | 字段名称列表 | 仅用于序列化输出的字段 |
| extra_kwargs | 要添加或修改的选项对象 | 添加或修改原有的选项参数 |
from rest_framework import serializers
from quickstart.models import BookInfo, UserInfo


class UserInfoSerializer(serializers.ModelSerializer):
    class Meta:
        model = UserInfo
        fields = ('id', 'name', 'gender', 'is_delete')


class BookInfoSerializer(serializers.ModelSerializer):
    class Meta:
        model = BookInfo
        fields = '__all__'
        # 只读字段,只能序列化输出,不能反序列化更改
        read_only_fields = ('id', 'read', 'comment')
        # 添加额外的选项参数
        extra_kwargs = {
            'read': {'min_value': 0, 'required': True},
            'comment': {'min_value': 0, 'required': True},
        }
2. 验证测试
- 使用序列化
>>> from quickstart.models import BookInfo
>>> from quickstart.serializers import BookInfoSerializer
>>> # 1.获取将要序列化的对象
>>> book = BookInfo.objects.get(id=1)
>>> # 2.创建序列化器
>>> serializer = BookInfoSerializer(instance=book)
>>> # 3.打印序列化器
>>> print(repr(serializer))
BookInfoSerializer(instance=<BookInfo: 孙子兵法-2>):
    id = IntegerField(label='ID', read_only=True)
    name = CharField(label='书名', max_length=20)
    releas_date = DateField(label='发布日期')
    read = IntegerField(label='阅读量', min_value=0, read_only=True)
    comment = IntegerField(label='评论量', min_value=0, read_only=True)
    is_delete = BooleanField(label='逻辑删除', required=False)
    author = PrimaryKeyRelatedField(label='作者', queryset=UserInfo.objects.all())
>>> # 4.打印序列后的数据
>>> print(serializer.data)
{'id': 1, 'name': '孙子兵法-2', 'releas_date': '2020-02-02', 'read': 10, 'comment': 5, 'is_delete': False, 'author': 1}
- 使用反序列化
数据创建
>>> from quickstart.serializers import BookInfoSerializer
>>> # 1.模拟前端传入的json数据
>>> new_book = {
...     "name": "水浒传",
...     "releas_date": "2021-01-01",
...     "author": 1
... }
>>> # 2.创建序列化器
>>> serializer = BookInfoSerializer(data=new_book)
>>> # 3.数据校验
>>> serializer.is_valid(raise_exception=True)
True
>>> # 4.数据入库
>>> serializer.save()
<BookInfo: 水浒传>
>>>
数据更新-更新单个字段
>>> from quickstart.models import BookInfo
>>> from quickstart.serializers import BookInfoSerializer
>>> # 1.获取将要序列化的对象
>>> book = BookInfo.objects.get(id=1)
>>> # 2.模拟前端传入的json数据
>>> new_data = {
...     "name": "水浒传奇"
... }
>>> # 2.创建序列化器(默认传入所有required字段,使用partial=True设置部分字段更新)
>>> serializer = BookInfoSerializer(book, new_data, partial=True)
>>> # 3.数据校验(如果校验不通过,提示详细信息)
>>> serializer.is_valid(raise_exception=True)
True
>>> # 4.数据入库
>>> serializer.save()
<BookInfo: 水浒传奇>
3. 使用序列化(Serializer)
- app模型(module)
from django.db import models


class UserInfo(models.Model):
    name = models.CharField(max_length=20, verbose_name='姓名')
    GENDER_CHOICES = (
        (0, 'men'),
        (1, 'women')
    )
    gender = models.SmallIntegerField(choices=GENDER_CHOICES, default=0, verbose_name='性别')
    is_delete = models.BooleanField(default=False, verbose_name='逻辑删除')

    class Meta:
        verbose_name = '作者信息'
        verbose_name_plural = verbose_name

    def __str__(self):
        return self.name


class BookInfo(models.Model):
    name = models.CharField(max_length=20, verbose_name='书名')
    releas_date = models.DateField(verbose_name='发布日期')
    read = models.IntegerField(verbose_name='阅读量', default=0)
    comment = models.IntegerField(verbose_name='评论量', default=0)
    is_delete = models.BooleanField(default=False, verbose_name='逻辑删除')
    author = models.ForeignKey(UserInfo, on_delete=models.CASCADE, verbose_name='作者')

    class Meta:
        verbose_name = '图书信息'
        verbose_name_plural = verbose_name

    def __str__(self):
        return self.name
- app序列化器(serializers)
from rest_framework import serializers

from quickstart.models import BookInfo, UserInfo

# 用户信息序列化器
class UserInfoSerializer(serializers.ModelSerializer):
    class Meta:
        model = UserInfo
        fields = ('id', 'name', 'gender', 'is_delete')

# 图书信息序列化器
class BookInfoSerializer(serializers.ModelSerializer):
    class Meta:
        model = BookInfo
        fields = '__all__'
- app视图(views)
from django.http import HttpResponse
from django.views.decorators.csrf import csrf_exempt
from rest_framework.renderers import JSONRenderer
from rest_framework.parsers import JSONParser
from quickstart.models import BookInfo
from quickstart.serializers import BookInfoSerializer


class JSONResponse(HttpResponse):
    """
    将内容渲染成JSON的HttpResponse
    """

    def __init__(self, data, **kwargs):
        content = JSONRenderer().render(data)
        kwargs['content_type'] = 'application/json'
        super(JSONResponse, self).__init__(content, **kwargs)


@csrf_exempt
def BookInfoView(request):
    """
    列出所有的book信息,或创建一个新book。
    """
    # 获取所有书籍信息列表
    if request.method == 'GET':
        books = BookInfo.objects.all()
        serializer = BookInfoSerializer(books, many=True)
        return JSONResponse(serializer.data)

    # 新增一个数据信息
    elif request.method == 'POST':
        book = JSONParser().parse(request)
        serializer = BookInfoSerializer(data=book)
        if serializer.is_valid():
            serializer.save()
            return JSONResponse(serializer.data, status=201)
        return JSONResponse(serializer.errors, status=400)


@csrf_exempt
def BookInfoDetailView(request, book_id):
    """
    获取,更新或删除一个指定ID的book。
    """
    try:
        book = BookInfo.objects.get(pk=book_id)
    except BookInfo.DoesNotExist:
        return HttpResponse(status=404)

    # 获取指定书籍信息
    if request.method == 'GET':
        serializer = BookInfoSerializer(book)
        return JSONResponse(serializer.data)

    # 修改指定数据信息
    elif request.method == 'PUT':
        data = JSONParser().parse(request)
        serializer = BookInfoSerializer(book, data=data)
        if serializer.is_valid():
            serializer.save()
            return JSONResponse(serializer.data)
        return JSONResponse(serializer.errors, status=400)

    # 删除指定数据信息
    elif request.method == 'DELETE':
        book.delete()
        return HttpResponse(status=204)
- app路由(urls)
from django.urls import path
from quickstart import views

urlpatterns = [
    path('books/', views.BookInfoView),
    path('books/<int:book_id>', views.BookInfoDetailView)
]
- 项目根路由(urls)
from django.urls import path, include
from django.contrib import admin

urlpatterns = [
    path('admin/', admin.site.urls),
    path('v1/', include('quickstart.urls')),
]