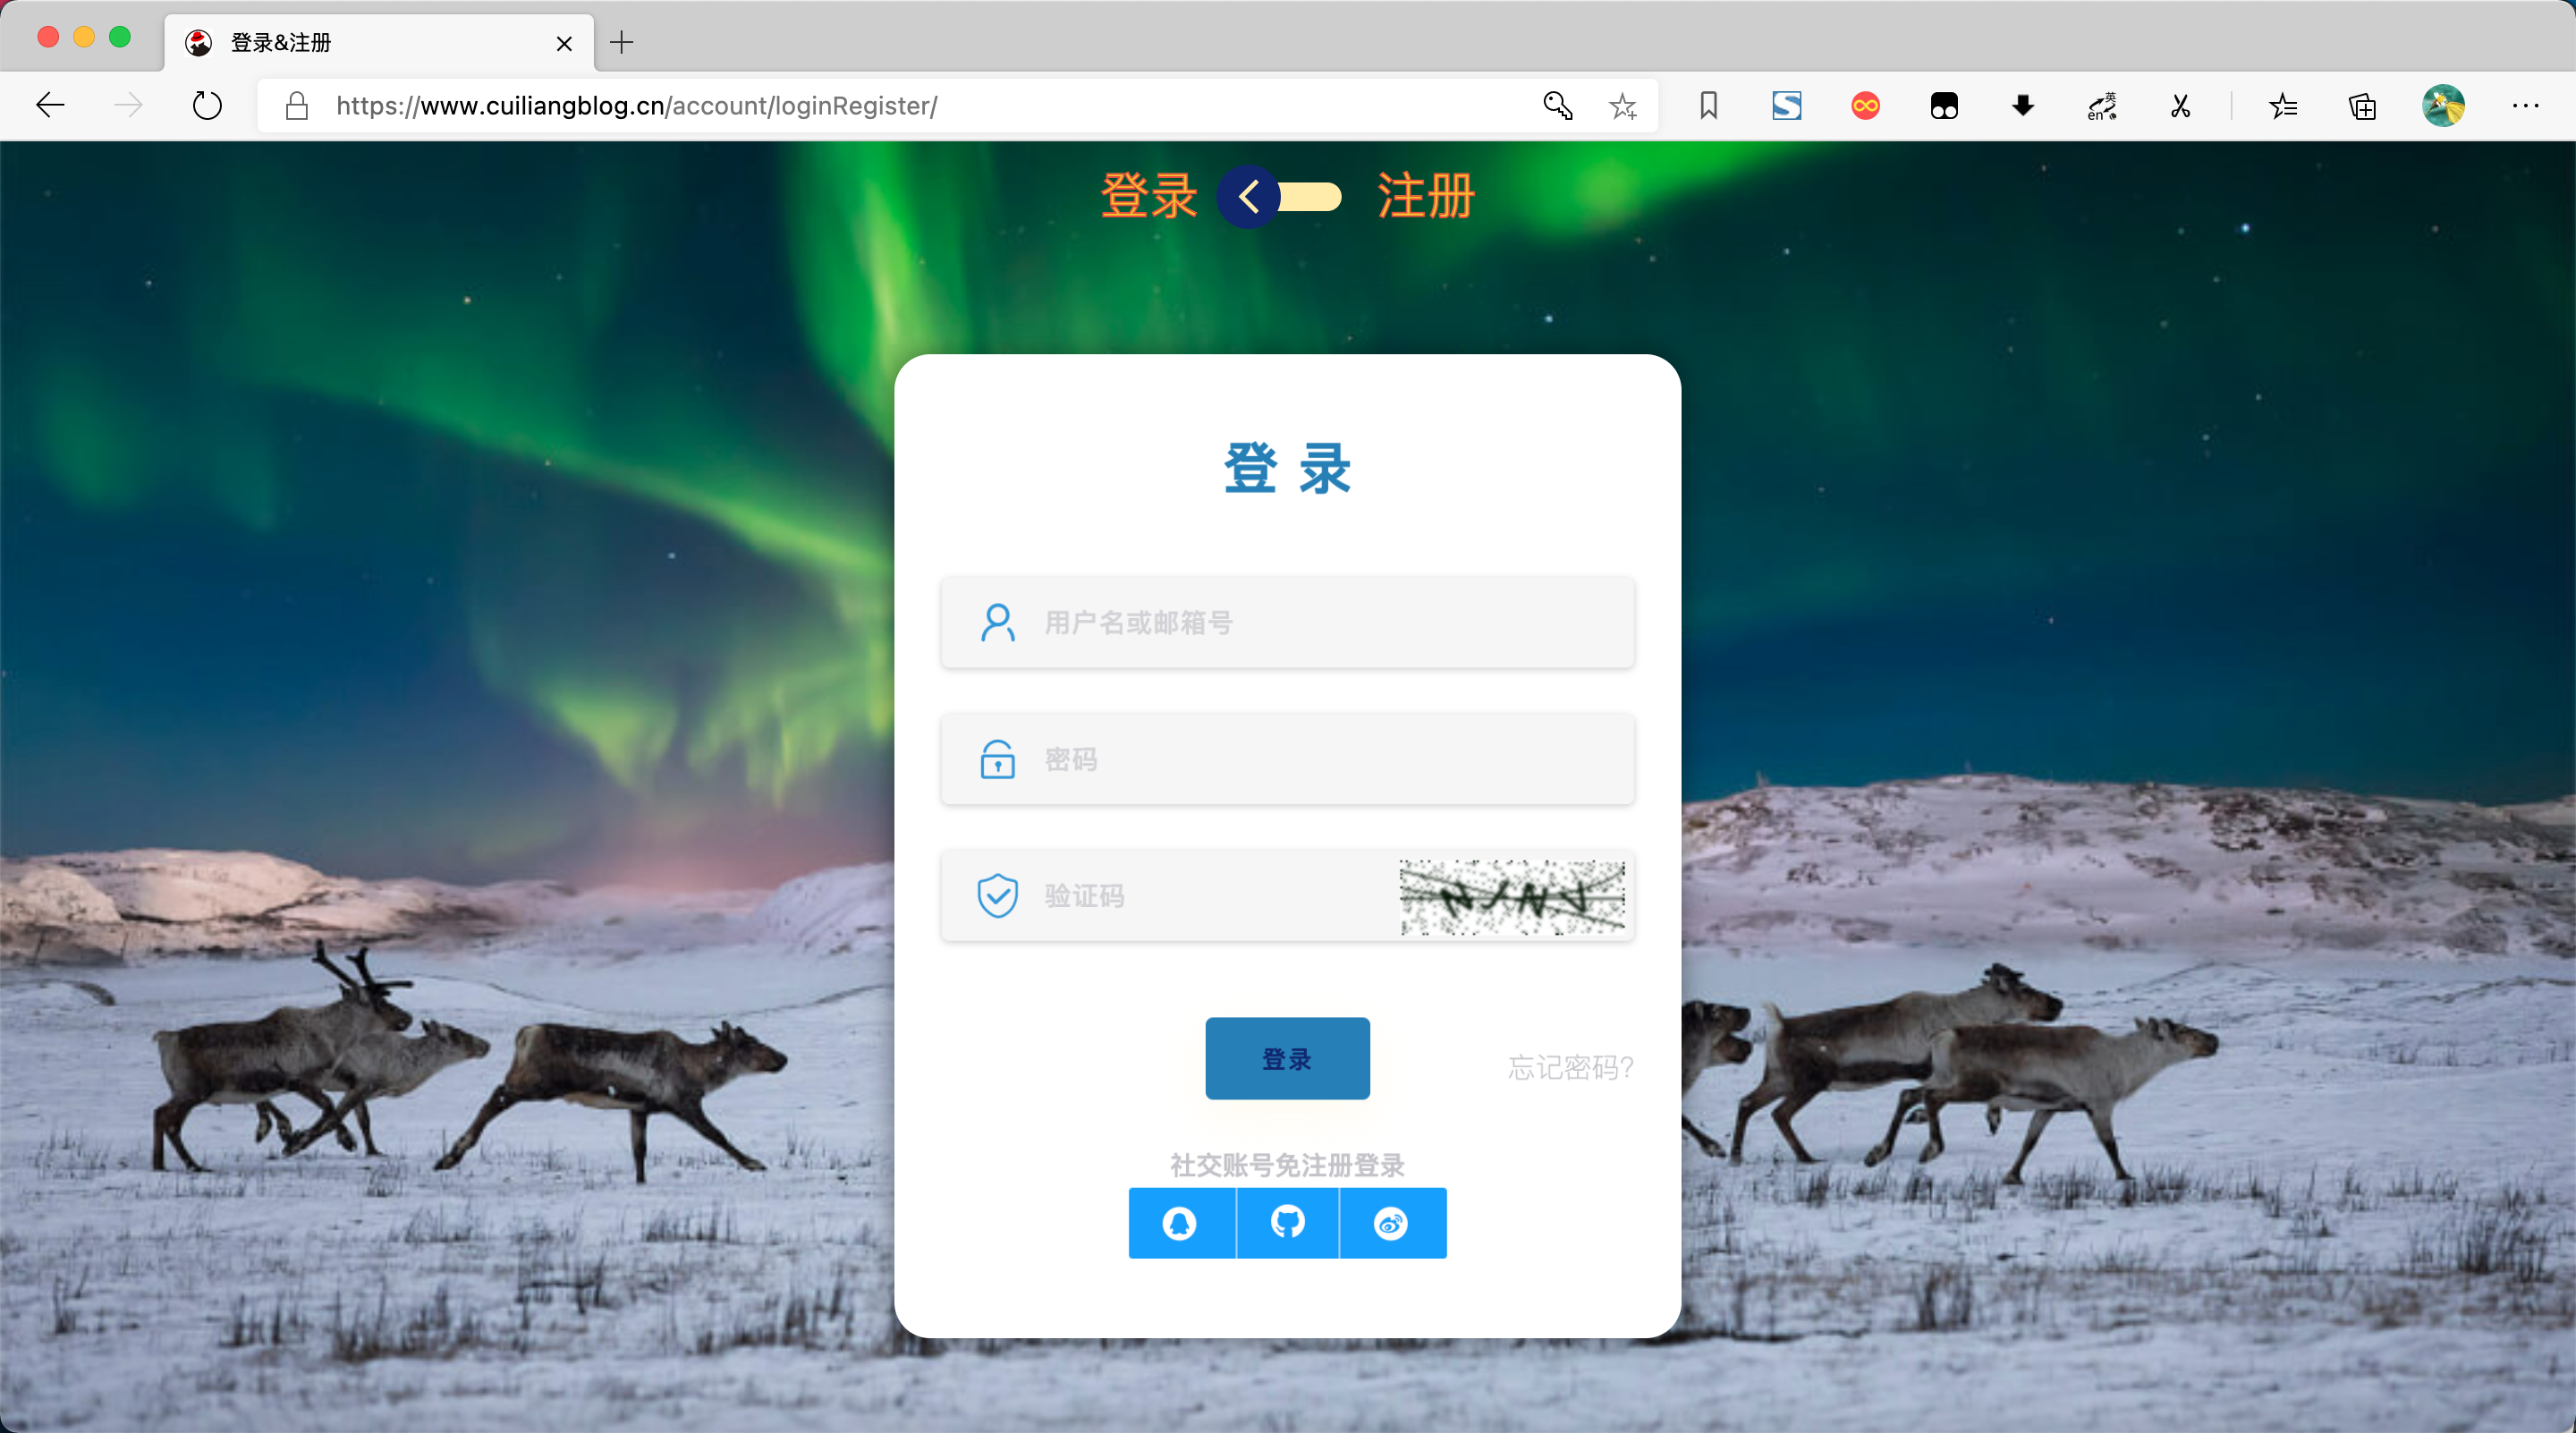
最近在做登录页时,对于有选择困难症的我来说,选哪一张图片做背景图片是一件十分头疼的事。既然这样,那就每天定时爬取必应的壁纸作为背景图片,毕竟必应每天的图片质量都是挺不错的。有时候,没有选择就是最好的选择。
一、获取图片下载地址
1. 分析必应网站html代码结构
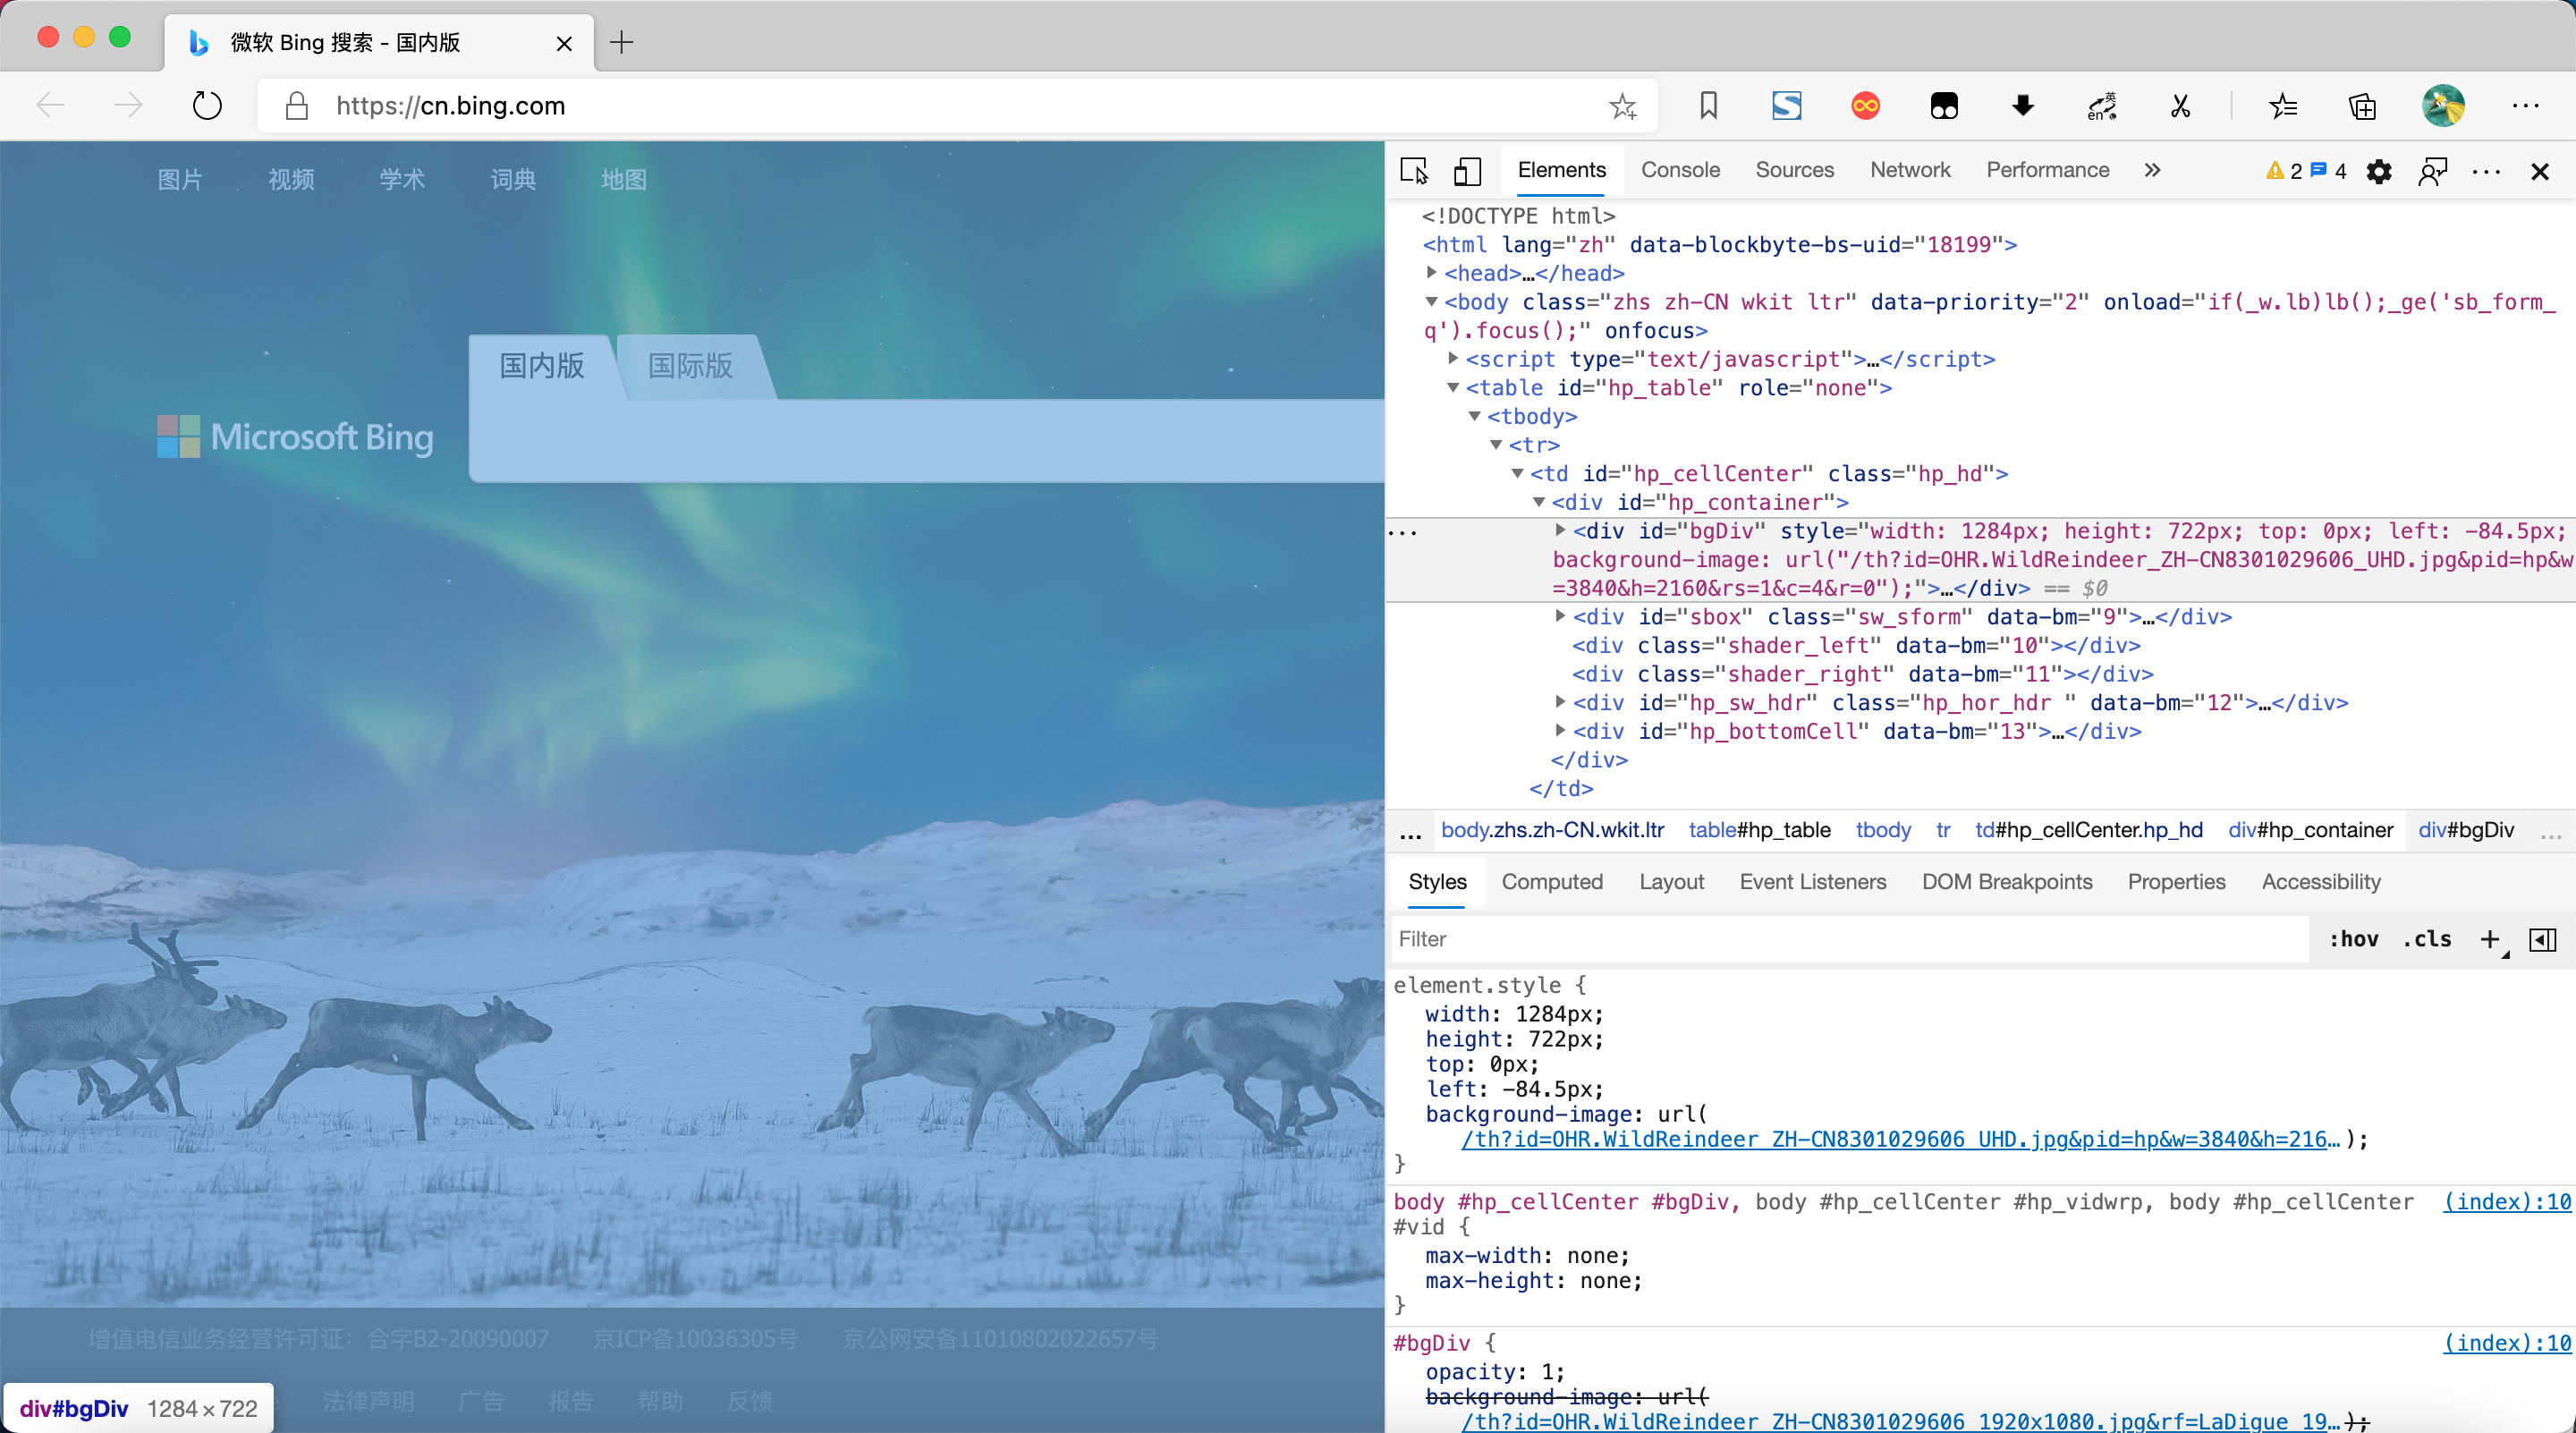
- 分析html代码可知,图片背景图片的地址是域名(https://cn.bing.com/)与div元素background-image属性地址(/th?id=OHR.WildReindeer_ZH-CN8301029606_UHD.jpg&rf=LaDigue_UHD.jpg&pid=hp&w=1920&h=1080&rs=1&c=4)拼接而来
2. 获取div元素background-image属性
- 使用requests库发送get请求,获取html代码,然后解析出background-image属性值,拼接得到实际背景图片下载地址。
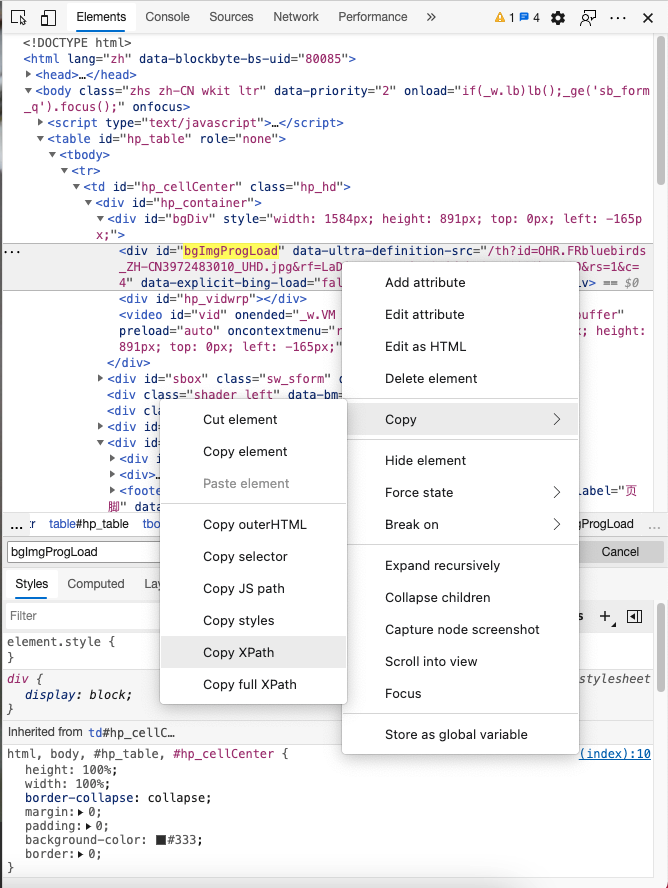
- 从html代码中解析出属性值,可以采用正则方法匹配或者xpath解析,在这儿分享一个快速写xpath表达式的技巧
url = 'https://cn.bing.com/'
# 设置浏览器参数
header = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/76.0.3809.132 Safari/537.36',
    # referer的作用就是记录你在访问一个目标网站时,在访问前你的原网站的地址
    'Referer': 'https://cn.big.com/'
}
# 下载网页html代码
html = requests.get(url, headers=header).text
# 构造xpath的解析对象
etree_html = etree.HTML(html)
# 获取图片地址
data_url = etree_html.xpath('//*[@id="bgImgProgLoad"]/@data-ultra-definition-src')[0]
img_url = "https://cn.bing.com/" + data_url
print('图片下载地址:', img_url)
二、图片压缩
默认下载的图片是1080P的大图,直接设置为背景图片的话,对带宽压力较大。因此需要进行压缩图片处理,可以使用pillow库在保存图片时指定分辨率大小,但会使图片变得模糊。 在此推荐给大家一个在线压缩图片地址https://tinypng.com/。压缩后图片依然清晰,最重要的是它有python sdk库,方便调用。
1. 申请API key
先在他们的网站TinyPNG Developer API上申请一个API key用于身份验证。只需要提供你的名字和邮箱地址就可以获得一个API key,API key会以链接的形式发到邮箱里。
2. 调试demo程序
参考文档:https://tinypng.com/developers/reference/python
import tinify
tinify.key = "YOUR_API_KEY"
source = tinify.from_file("large.jpg")
resized = source.resize(
    method="fit",
    width=150,
    height=100
)
resized.to_file("thumbnail.jpg")
三、完整代码
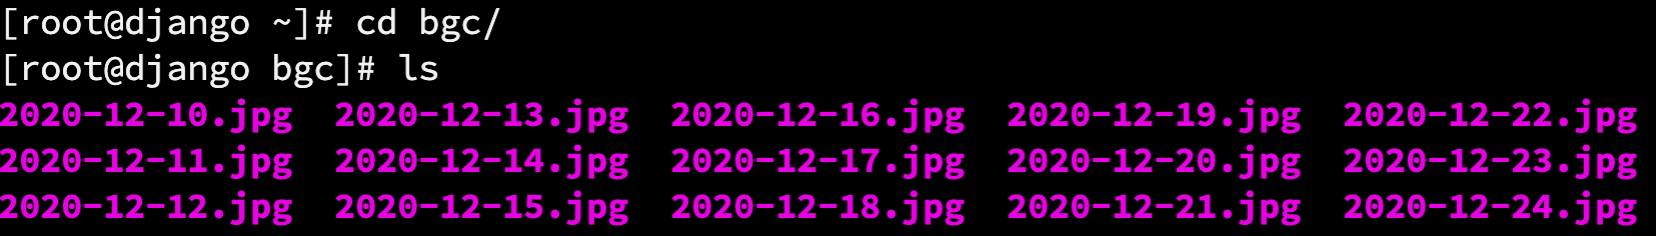
- 使用crontab计划任务,每天凌晨执行一次脚本,下载必应壁纸原图到/root/bgc下,文件名为当天时间戳,然后使用TinyPN压缩图片,生成新文件至/root/myblog/static/images下,命名为bg-img.jpg,从而实现每日壁纸自动更换。
#!/usr/bin/python3
# 定时更新登录页背景图

import os
import time
import request
import click
import tinify
import requests


# 获取必应每日壁纸img下载地址
def get_img_url():
    url = 'https://cn.bing.com/'
    # 浏览器参数
    header = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/76.0.3809.132 Safari/537.36',
        # referer的作用就是记录你在访问一个目标网站时,在访问前你的原网站的地址
        'Referer': 'https://cn.bing.com/'
    }
    # 下载网页
    html = requests.get(url, headers=header).text
    # 构造xpath的解析对象
    etree_html = etree.HTML(html)
    # 获取图片地址
    data_url = etree_html.xpath('//*[@id="bgImgProgLoad"]/@data-ultra-definition-src')[0]
    img_url = "https://cn.bing.com/" + data_url
    print('图片下载地址:', img_url)
    return img_url


# 保存图片到磁盘文件夹dirname中
def save_img(img_url, dirname):
    try:
        if not os.path.exists(dirname):
            print('文件夹', dirname, '不存在,重新建立')
            # os.mkdir(dirname)
            os.makedirs(dirname)
        # 获得图片文件名,包括后缀
        date = time.strftime('%Y-%m-%d', time.localtime(time.time()))
        filename = date + '.jpg'
        # 拼接目录与文件名,得到图片路径
        filepath = os.path.join(dirname, filename)
        # 下载图片,并保存到文件夹中
        print("保存地址:", filepath)
        urllib.request.urlretrieve(img_url, filepath)
    except IOError as e:
        print('文件操作失败', e)
    except Exception as e:
        print('错误 :', e)
    print(filepath, "保存成功!")
    return filepath


# 压缩图片
def zip_img(in_file, out_file):
    tinify.key = "***"
    source = tinify.from_file(in_file)  # 压缩指定文件
    resized = source.resize(
        method="fit",
        width=1024,
        height=768
    )
    resized.to_file(out_file)
    print(out_file, "压缩完成!")


def main():
    # 下载保存图片
    dirname = "/root/bgc"
    img_url = get_img_url()
    file_path = save_img(img_url, dirname)

    # 压缩图片
    img_dir = "/root/myblog/static/images"  # 输出目录
    img_name = 'bg-img.jpg'
    img_path = img_dir+"/"+img_name
    zip_img(file_path, img_path)


if __name__ == '__main__':
    main()
四、效果演示
- 必应壁纸原图文件